L’UE impuissante face aux géants de l’IA qui contournent transparence et obligations
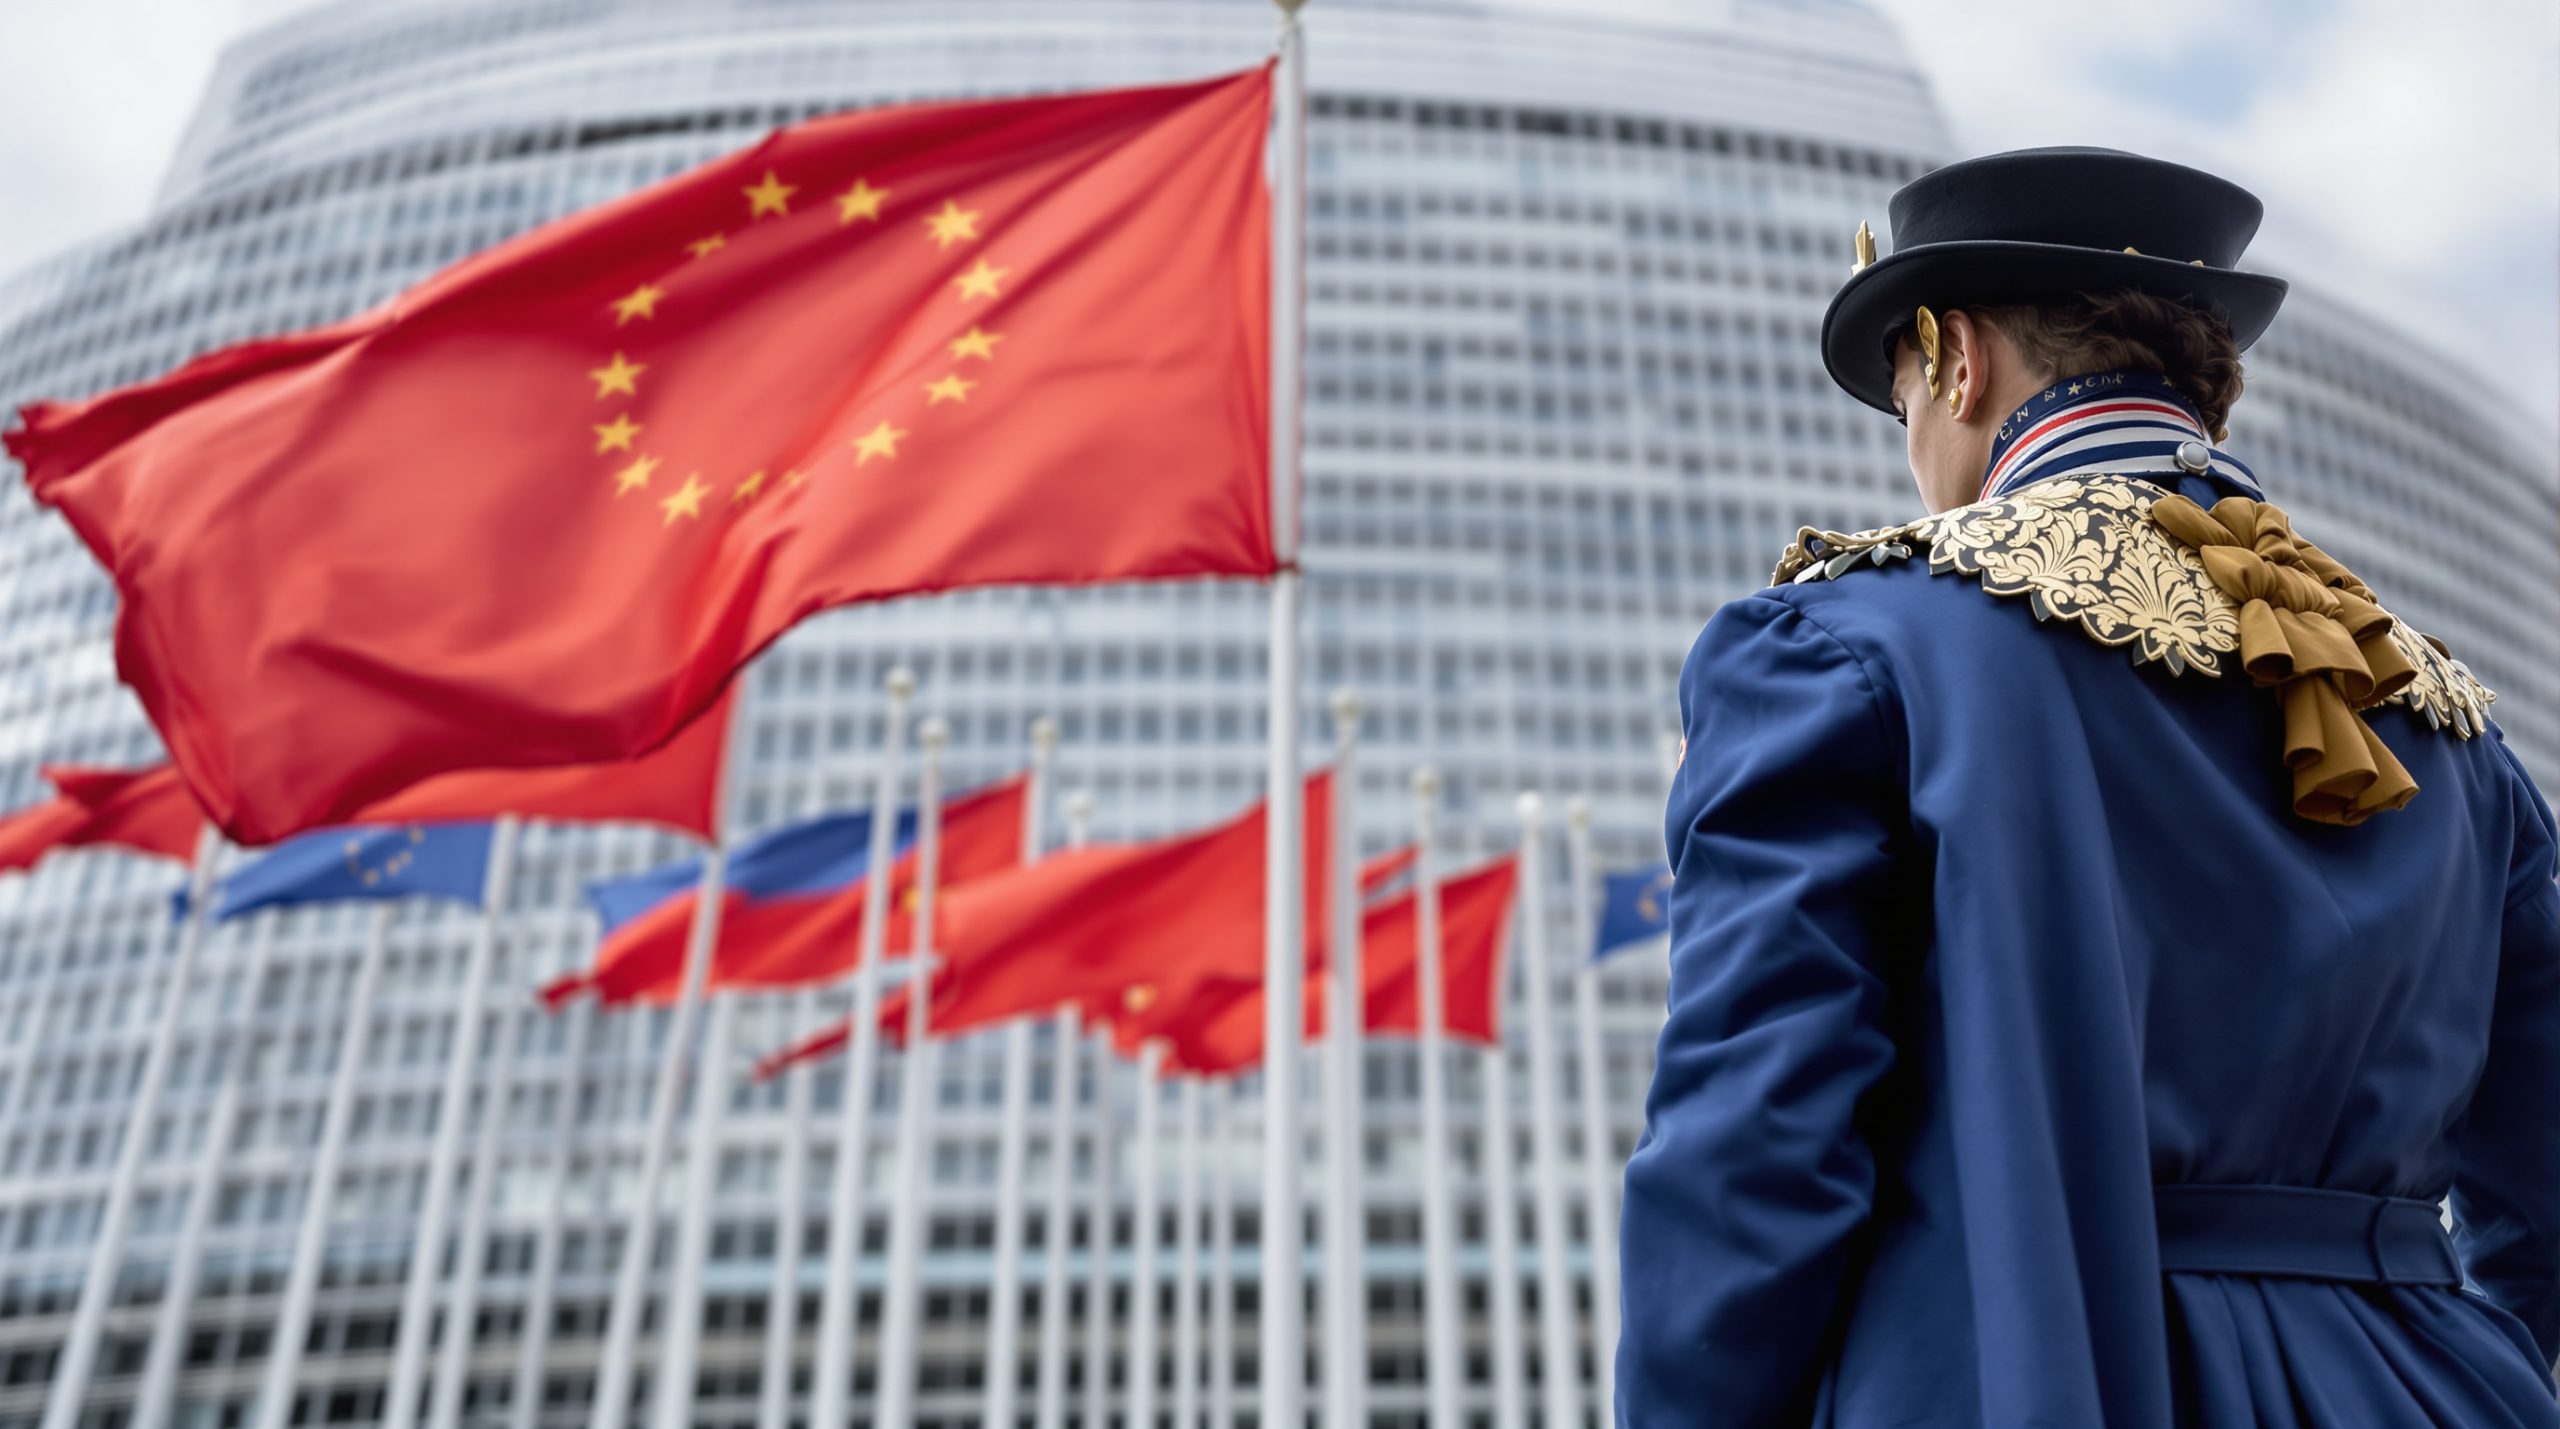
L’Union européenne a imposé de nouvelles règles de transparence aux développeurs d’intelligence artificielle. Depuis août 2025, ces entreprises doivent dévoiler les contenus utilisés pour former leurs modèles. Pourtant, un an après l’entrée en vigueur de cette obligation, les résultats s’avèrent décevants pour les détenteurs de droits d’auteur.
Des obligations européennes largement contournées
Depuis le 2 août 2025, une nouvelle réglementation contraint les concepteurs de modèles d’IA à usage général à publier un document récapitulatif. Ce texte doit préciser les principaux domaines numériques exploités lors de l’apprentissage automatique.
Les modèles lancés sur le territoire européen après cette date doivent s’y conformer immédiatement. Ceux déjà commercialisés disposent d’un délai supplémentaire jusqu’au 2 août 2027. La Commission européenne peut sanctionner les contrevenants depuis août 2026.
Vingt-quatre résumés examinés, zéro site identifié
Une analyse menée fin septembre 2026 a passé au crible 24 documents provenant de sept fournisseurs majeurs. Le constat est sans appel : sur 21 résumés étudiés, aucun ne mentionne de plateforme web spécifique.
Les entreprises se contentent de catégories génériques : plateformes en ligne, services d’hébergement ou ressources académiques. Cette approche vague empêche les éditeurs et créateurs de contenu de vérifier si leurs œuvres ont été utilisées.
DeepSeek et Ant Group : les cas les plus problématiques
Les trois publications de DeepSeek se distinguent par l’absence totale de la section consacrée aux domaines exploités. Une omission qui interroge sur la volonté réelle de transparence.
Ant Group a diffusé onze documents suivant un modèle standardisé. Seules mentions concrètes : Ant Spider et Common Crawl pour le modèle Ling-2.0, ainsi qu’une référence à Stack Exchange dans les textes de DeepSeek.
OpenAI, ByteDance et MiniMax : le flou artistique
Le créateur de ChatGPT, comme ses concurrents chinois ByteDance et MiniMax, privilégie des formulations évasives. Ils évoquent des contenus liés à certains secteurs d’activité sans jamais nommer précisément les sources.
Cette stratégie rend impossible pour un détenteur de droits de déterminer si son travail a alimenté ces systèmes d’intelligence artificielle sans démarche administrative supplémentaire.
Un mécanisme de contrôle défaillant
La réglementation européenne prévoit que cette liste facilite la vérification par les titulaires de droits. Dans les faits, l’objectif initial n’est pas atteint : éviter aux créateurs de devoir interroger individuellement chaque fournisseur.
Les entreprises peuvent fournir des informations complémentaires sur demande, mais cette démarche reste facultative. Elles se contentent de mentionner le respect des protocoles techniques comme le fichier robots.txt ou les systèmes anti-robots.
La Commission européenne face à ses responsabilités
C’est à Bruxelles que revient la tâche de vérifier la conformité de ces documents avec l’article 53 du règlement. Les notices encouragent néanmoins les développeurs à répondre favorablement aux demandes d’information des ayants droit.
La question demeure : la Commission utilisera-t-elle ses pouvoirs de sanction face à cette transparence de façfaçade ? Les prochains mois seront déterminants pour l’efficacité de cette législation pionnière.
Laisser un commentaire